Een project bouwen in Python
Inleiding
Wanneer we een meer complexe applicatie bouwen in Python, dan zijn er een aantal zaken waar we aandacht moeten aan besteden:
- Versiecontrole met git: welke .gitignore hanteren we?
- Gebruik van een virtuele omgeving met .venv
- Correct gebruik van packages.
- Gevoelige gegeven niet in de broncode bijhouden.
Doelstellingen
Na het bestuderen van dit hoofstuk kan je:
- git gebruiken in een eenvoudig project;
- .gitignore correct instellen;
- een virtuele Pythonomgeving maken en gebruiken;
- modules en packages correct gebruiken;
- een oplossing hanteren om gevoelige gegevens niet in de broncode op te slaan.
Bronnen
venv - Creation of virtual environments
Git en .gitignore
Git
Professionele systeembeheerders en softwareontwikkelaars houden hun code altijd bij een versiebeheersysteem. Er bestaat hier een brede keuze aan mogelijkheden, maar sinds de ontwikkeling van git door Linus Thorvalds is dit de de facto standaard geworden. Wij zullen dus gebruik maken van Git als versiebeheersysteem.
Een versiebeheersysteem is cruciaal wanneer je met meerdere softwareontwikkelaars samenwerkt, maar is ook heel belangrijk als je met één ontwikkelaar iets opbouwt, omdat het je de mogelijkheid geeft om terug te keren naar vorige versies van je code en omdat het mogelijk wordt je code snel te delen, én snel op een server te deployen.
De omgeving waarin je je code bijhoudt, noemen we een repository. Typisch aan git is, dat je één of meerdere lokale repositories hebt. Dit betekent dat je code zich op je lokale computer bevindt, in een map met de verborgen map .git. Normaal gezien zal je deze lokale repo verbinden met een "remote repository". Dat is een repository op een server.
We zullen hier geen volledige cursus Git geven. We gaan ervan uit dat je in andere vakken met Git kennisgemaakt hebt. We beperken ons hier tot een samenvatting.
Een remote repository creëren
Je kan een remote repo maken op diverse cloudplatformen zoals Github, Bitbucket, Gitlab, enzovoort. In deze cursus zullen we Github gebruiken.
We voorzien in onze repo altijd een bestand README.md. Dat is een markdownbestand waarmee je info geeft over je applicatie:
- Wat de bedoeling is van de applicatie.
- Welke functionaliteiten gerealiseerd zijn.
- Hoe je de applicatie moet runnen:
- Voorbeelden van de instellingsbestanden.
- Eventueel de structuur van de database.
Een remote repository clonen
Je kan een repo lokaal creëren en dan connecteren met een remote repository, maar bij de start van een project is de eenvooudigste werkwijze om de remote repo te klonen. Er wordt dan een lokale kopie gemaakt:
git clone <link to repo>
Je zal ongetwijfeld je gebruikersnaam of wachtwoord moeten opgeven. Het is mogelijk dat je een lokale ssh-key moet creëren of een application password. De uitleg daarover vind je op de site van github.
Staging, commit, push en pull
Wanneer er iets gewijzigd is aan je programmacode, dan die wijziging bijgehouden wordt. Je wacht hiervoor niet tot alle functionaliteiten uitgewerkt zijn, maar bij elke toevoeging die leidt tot een toestand die geen fatale crashes oplevert, zullen we de een commit doen. Je doet dus bijna dagelijks een commit.
Je kan Git gebruiken via de commandolijn, via een plugin in Sublime of via Github desktop, een meer grafische tool. Wij vatten hier nog snel eens de commando's samen die je in je terminal kan gebruiken.
Eerst zal je de gewijzigde bestanden toevoegen aan de "staging-fase".
git add <naam bestand>
of
git add -A
Je kan de status van je repo opvragen via:
git status
Na het toevoegen van de gewijzigde bestanden zal je een commit doen. We geven altijd een betekenisvolle boodschap mee met de commit:
git commit -m 'toevoegen van een product voorzien in back-end'
De laatste stap is dan de commits van die dag pushen naar de remote repository:
git push
Wanneer iemand anders aan de code gaat werken, of je werkt zelf aan de code in de andere machine, dan moet je je lokale repository weer up te date brengen met een pull-commando.
git pull
Bij het ontwikkelen kan je meerdere deeltaken of branches creëren en die dan samenvoegen (merge). We zullen het hier niet over branching hebben. Ook de meer complexe toepassingen van git laten we achterwege. Voor een workflow waar je alleen aan een project werkt, volstaat dit.
.gitignore
Het is belangrijk om ervoor te zorgen dat je geen bestanden in de git-repository opneemt die daar niet thuis horen:
- gecompileerde code;
- instellingsbestanden die kunnen variëren naargelang de omgeving, bijvoorbeeld met databaseconnecties;
- bestanden met wachtwoorden;
- de reële database (een voorbeelddatabase kan eventueel wel).
- ...
De bestanden of mappen die door git genegeerd moeten worden, plaatsen we in een tekstbestand met de naar .gitignore. Dit bestand nemen we wel op in git.
Een typisch .gititgnore-bestand voor een eenvoudig Pythonproject vind je hieronder met wat uitleg.
# gecompileerde bestanen of mappen waar we die terugvinden
__pycache__/
*.py[cod]
*$py.class

# C extensions
*.so

# de database zelf
dbproject.sqlite3
project.db

# instellingsbestanden
settings.py
.env

# verborgen map van de virtuele omgeving

.env
.venv
env/
venv/
Een virtuele omgeving creëren met venv
Wanneer we geregeld bezig zijn met Python, dan lopen we het risico dat onze computer vol staat met allerlei projecten die telkens verschillende versies van Python vereisen en die verschillende geïnstalleerde modules vragen. Daarom zullen gebruik maken van een virtuele Pythonomgeving.
Er bestaan diverse modules die dit realiseren, bijv. Virtualenv, maar in deze cursus houden we het bij de standaardmodule die bij Python is meegeleverd: venv
Bestudeer de documentatie. Wij vatten hier de belangrijkste elementen samen:
- We creëren een virtuele omgeving. Dit doen we in een verborgen map in onze projectmap. We kunnen die map gelijk welke naam geven, maar gebruikelijk zijn namen als
.venvof.env. Daarmee wordt in onze projectmap een versie van Python geïnstalleerd. - We activeren die virtuele omgeving.
- Als we nu packages installeren, dan zijn die geïsoleerd in dit virtuele omgeving en hebben ze geen enkele impact op de rest van ons systeem.
Virtuele omgeving creëren in de verborgen map .venv:
python -m venv .venv
We activeren die virtuele omgeving. In Mac en linux vindt je in de verborgen map een submap bin met de nodige scripts. In Windows heb je een submap Scripts.
Activeren in Mac of linux:
source .venv/bin/activate
Activeren in Windows in cmd
.venv/Scripts/activate.bat
Activeren in Windows in Powershell:
.venv/Scripts/activate.ps1
We kunnen nu de nodige packages installeren, bijv. pandas
pip install pandas
Deze packages blijven binnen deze virtuele omgeving.
We deactiveren de virtuele omgeving met het commando deactivate.
Wanneer we nu onze applicaties willen klaarmaken voor deployment op een server, dan zullen we de volgende stappen zetten:
- we verzamelen op onze ontwikkelingsmachine de lijst van geïnstalleerde packages in bestand
requirements.txt. - we pushen onze code én
requirements.txtnaar de git-repository. - op onze server pullen we onze code in de repository op de server.
- we vullen eventueel ons bestand met instellingen in.
- we creëren een virtuele omgeving op de server.
- we installeren de packages op basis van
requirements.txt
Dus, op onze ontwikkelingsmachine:
Eerste de geïnstalleerde pakketten verzamelen in requirements.txt.
pip freeze > requirements.txt
Dit bestand in onze lokale repo committen en pushen naar de server.
git add requirements.txt
git commit -m 'toevoegen requirements.txt'
git push
Dan loggen we in op de server waar onze applicatie moet komen. We zullen eerste de laatste versie van de code ophalen:
git pull
Daarna zullen we de virtuele omgeving creëren, activeren en alle packages installeren:
python -m venv .venv
source .venv/bin/activate
pip install -r requirements.txt
Virtuele omgevingen in Spyder gebruiken
Waneer we voor ons project een virtuele omgeving gecreëerd hebben, dan willen we ook dat Spyder de Pythonruntime van deze virtuele omgeving gebruikt. Hoe brengen we dat tot stand?
- Je gaat naar "Preferences". Op Windows vind je dit onder "Tools", bij Mac in het menu "Spyder6".
- Je kiest voor "Python interpreter".
- Kies dan in plaats van "internal" voor "Use the following interpreter".
- Kies de map waarin Python.exe zich bevindt binnen de verborgen map van je virtual environment.
- Test dan of dit werkt, bijv. door een package te importeren dat je met pip geïnstalleerd hebt binnen je virtuele omgeving.
Correct gebruik maken van packages
Python code wordt in een tekstfile met extensie .py opgeslagen. De file wordt dan door Python ingelezen en uitgevoerd. Deze file noemt men een script. De code in het script is bedoeld om direct uitgevoerd te worden.
Je kan echter ook code in een tekstfile met extensie .py bewaren die niet bedoeld is om direct uit te voeren, maar die als library moet fungeren. Dit noemt men een module. De code in een module is bedoeld om in een ander stuk code gebruikt te worden.
Fysiek is er geen verschil tussen een script en een module, want in beide gevallen gaat het om een tekstbestand met extensie .py. Het verschil ligt enkel in het gebruik. Code in een script kan ook geïmporteerd worden in een ander stuk code, maar dat is niet de bedoeling. Een script wordt enkel uitgevoerd. Evenzo kan men een module runnen, maar ook dat is niet de bedoeling. Een module bestaat meestal enkel uit klassen en functies, die in andere code moeten worden geïmporteerd.
Een package is een verzameling van modules. Fysiek is dit gewoon een folder die de modules als py-files bevat. Daarnaast moest die folder ook een __init__.py file bevatten in oudere versies Python. Die file is meestal leeg, maar kan ook code bevatten die moet worden uitgevoerd bij het importeren van de package. Vanaf Python 3.3 hoeft die __init__.py file niet meer. Men spreekt in dit geval van een "namespace package". De packages met een __init__.py file noemt men "regular packages".
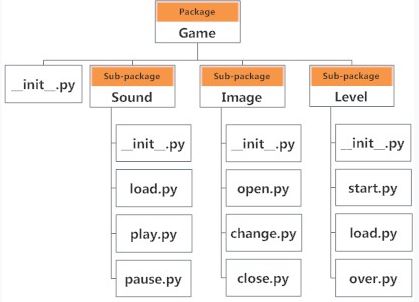
Een package kan ook subpackages bevatten, zoals op onderstaande figuur is te zien. De package Game bestaat uit drie subpackages Sound, Image en Level. Subpackage Sound bevat drie modules: load, play en pause; subpackage Image bevat modules open, change en close; subpackage Level bevat modules start, load en over. Zowel Sound als Level bevatten een module load, maar doordat ze in een aparte subpackage zitten, is er geen naamconflict mogelijk. Dit is een mooi voorbeeld van hoe packages en modules kunnen gebruikt worden om code op een hoger niveau te structureren.
Externe modules installeer je met het command pip install <naam van de modules>. Je importeert dan de module als volgt:
import numpy as np
We hebben dit al gezien bij functies. Je kan de module een alias geven.
Je kan ook individuele functies importeren
from math import sqrt as vierkantswortel
Je kan dus eigen modules ontwikkelen. Deze bevatten dan klassen en functies die in andere modules gebruikt kunnen worden. In het Python-bestand met de module zal je een onderscheid maken tussen de klassen en functies die door anderen gebruikt kunnen worden, en de code die enkel uitgevoerd wordt als dit bestand zelf als script uitgevoerd wordt. Deze code, die niet uitgevoerd mag worden bij een import, maar enkel als het bestand als script aangeroepen wordt, zetten we onder het volgende if-statement:
if __name__ == '__main__':
Als een eigen ontwikkelde module in dezelfde map zit als het script waarin je de module wil gebruiken, dan is het aanroepen eenvoudig: je importeert de module met de naam van het Pythonbestand zonder de extensie .py.
import mijnmodule # Pythonbestand heet mijnmodule.py
Je kan de lijst van functies en klassen in een module opvragen met het commando dir(<naam van de module>)
Je kan ook eigen packages aanmaken. Een package is een map die Pythonbestanden bevat. Je kan , voor compatibiliteit met oudere versies van Python, in die map een leeg bestand __init.py__ plaatsen. Een typisch project zal een reeks submappen met Pythonbestanden bevatten. We willen onze code immers zo modulair mogelijk maken, volgens het Singe Responsibility Principle, dat inhoudt dat een klasse zich focust op één of een beperkt aantal nauw gerelateerde taken.
Tot nu toe was een import van een eigen module gemakkelijk: als de module in dezelfde map stond, dan volstond het om de naam van het Pythonbestand zonder de extensie .py bij de import te vermelden. Als je project georganiseerd is in diverse mappen, dan wordt het iets complexer. Waar gaat Python zoeken wanneer je een import doet?
- In de huidige map van het script.
- In de lijst van mappen die gedefinieer dzijn in de omgevingvariabele (environment variable) PYTHONPATH. Dit is een omgevingsvariabele die dezelfde opbouw heeft als de variable PATH, maar typisch is voor Python.
- In een lijst van mappen die bij installatie meegegeven wordt. Bij een virtuele venv-omgeving zal Python bijvoorbeeld de geïnstalleerde pakketen terugvinden. Ook de pakketten die meegeïnstalleerd zijn met je Pythonversie vind Python terug.
In de interactieve versie van Python kan je het zoekpad terugvinden als volgt:
import sys
sys.path
Alle bovenstaande mappen worden toegevoegd aan de variabele sys.path. Je kan dus kiezen: de module staat in de huidige map, je voorziet een omgevingsvariabele PYTHONPATH of je past at runtime sys.path aan en voegt de hoofdmap aan de top van je hiërarchie toe. Je kan als ingangspunt van je project bijv. een bestand main.py voorzien die dat uitvoert en dan een andere startmodule aanroept.
import sys, os
sys.path.append(os.path.dirname((__file__))
Je kan de echte locatie van een module opvragen via de eigenschap __file__
Het expliciet toevoegen van het huidige pad aan sys.path is meestal niet nodig wanneer je startscript in de hoofdmap van je projet staat, want automatisch wordt de huidige directory van het aangeroepen script aan sys.path toegevoegd.
>>> import math
>>> math.__file__
'/Library/Frameworks/Python.framework/Versions/3.11/lib/python3.11/lib-dynload/math.cpython-311-darwin.so'
Nemen we nu het voorbeeld dat we hierboven al gebruikt hebben.
Hoe importeer je nu diverse packages in andere packages binnen deze applicatie? Mappen hebben een hiërarchische structuur. De map "Game" hebben we toegevoegd aan de omgevingsvariabele PYTHONPATH. Om modules in onderliggende packages aan te roepen, gebruiken we de dot-notatie, waarbij we submappen en modules scheiden door een punt.
import Game.Image.open
from Level import start, load, over
Je kan gewoon een package importeren, maar dat heeft weinig zin. Je moet importeren tot op het niveau van de module of de functie/klasse.
Je kan ook een relatieve import doen, die niet uitgaat van de top van de hiërarchie, maar van de huidige module. In Game.Sound.pause.py zou ik dus volgend statement kunnen hebben:
import ..Image.open
De twee puntjes verwijzen naar een bovenliggende map.
Het bestand __init.py__ kan leeg blijven, maar kan ook code bevatten die uitgevoerd wordt wanneer een package geïmporteerd wordt, zogenaamde initialisatiecode. Bij een import wordt __init__.py immers automatisch uitgevoerd. Een voorbeeld daarvan is het automatisch importeren van andere packages. Vroeger moest er altijd een __init__.py__ aanwezig zijn, maar dit is niet meer het geval.
Gevoelige gegevens bijhouden
In je Pythonprogramma heb je soms gegevens nodig:
- Die gevoelig zijn zoals wachtwoorden.
- Die verschillen op je ontwikkelcomputer en op de server, zoals connectiegegevens naar de database, mailadressen, enzovoort.
Het is dus geen goed idee om deze elementen in je code op te slaan en dus in je git-repository te committen.
Hoe gaan we daar mee om?
Een eenvoudige manier is om deze informatie op te slaan in een settings.py-bestand en dat bestand dan te importeren. Dit is een optie voor connectiegegevens of andere instelingen. Je voegt dit bestand (bijv. settings.py) toe aan git-ignore en je voorziet een correcte versie op je testserver, op je productieserver en op de computer waarop je aan het ontwikkelen bent. Deze methode is eenvoudig, maar niet erg geschikt voor wachtwoorden.
Een tweede optie is om bepaalde waarden bij te houden im omgevingsvariabelen. De omgevingsvariabelen krijgen dan een andere waarde op je ontwikkelcomputer, op je testserver en op je productieserver. Om de waarden van de omgevingsvariabelen uit te lezen gebruiken we het object os.environ. Dit object is een Dictionary die de waarden van de omgevingsvariabelen bevat. Wanneer we bijvoorbeelde de omgevingsvariabelen HOME willen uitlezen, dan doe we dat als volgt:
import os
mijn_thuis_map = os.environ['HOME']
Je kan dus ook omgevingsvariabelen voorzien voor diverse instellingen zoals je databaseconnectie.
Een gelijkaardige aanpak is om gevoelige data in een verborgen bestand .env te bewaren, dat niet aanwezig is in je git-repository. Python bevat modules die dit bestand zonder moeite kunnen inlezen.
from environs import Env # https://pypi.org/project/environs/

env = Env()
env.read_env() # read .env file if it exists

db_host = env.str("DB_HOST")
db_database = env.str("DB_DATABASE")
db_port = env.int("DB_PORT")
production = env.str("PRODUCTION")

user_home = env("HOME")
Deze oplossingen zijn al een stuk veiliger. Voor het bewaren van een passwoord kan je nog een stap verder gaan, meer bepaald het paswoord bewaren in een zogenaamde "vault", een veilige plaats waar je wachtwoorden geëncrypteerd worden en die je met code kan aanroepen. Je vindt hiervoor heel wat oplossingen, zowel commercieel als open-source. Infisical is een voorbeeld van een open-source platform.
Hoe structureer je je code?
Bij een project is het belangrijk om je code goed te structureren in packages (submappen) en modules (bestanden). Dit heeft heel wat voordelen:
- Duidelijkheid: als je maanden later je code moet debuggen of uitbreiden, is het essentieel om snel te kunnen zien waar bepaalde onderdelen zich bevingn.
- Herbruikbaarheid: door je code op te splisten in kleine eenheden, kan je die eenheden op diverse plaatsen binnen en buiten het project opnieuw gebruiken en vermijd je duplicatie van code.
- Testbaarheid: kleine eenheden kan je gemakkelijker testen, o.a. via unit tests.
- Maintainability: als je project een duidelijke structuur heeft, die bestaat uit kleinere eenheden, is het gemakkelijk om de code uit te breiden of bepaalde elementen (bijv. de UI, of de database) te vervangen.
We hanteren hiervoor bepaalde vuistregels:
- We zorgen dat ons project vertrekt vanuit één bestand main.py die zich in de hoofdmap bevindt.
- UI Layer. We zorgen dat de user-interface gescheiden is van de rest. Alles wat te maken heeft met input en output zit apart. Deze onderdelen doen wel een eerste controle op de validiteit van de input, maar bevatten voor de rest niet zoveel businesslogica. Dit maakt het mogelijk om later de UI te veranderne, bijv. van een CLI-applicatie naar een desktopapplicatie, of een webapplicatie.
- Data Access Layer. We voorzien de toegang tot de database in een aparte package, gescheiden van de rest. Dat maakt het gemakkelijk om de databasetoegang later te veranderen. Je zou kunnen starten met tekstbestanden als database, om dan later naar een relationele database over te schakelen. Het is zeker zo dat alle SQL-statements mooi samen zitten en niet verspreid zitten over het hele project. We zouden dit de Data Access Layer kunnen noemen.
- Domain Layer. We voorzien klassen om de domeinobjecten te definiëren. Dit zijn de objecten waar de applicatie echt over gaat. We denken bijvoorbeeld aan klassen als Klant, Afspraak, Product, Bestelling. Dit kunnen vrij eenvoudige klassen zijn in de vorm van data classes.
- Serice Layer. Complexe businesslogica, of het voorbereiden van data om die geschikt te maken voor output of voor opslag, situeren we in een aparte servicelaag.
Door te modulariseren verminderen we de afhankelijkheid van modules ten opzichte van elkaar.
- De UI zal afhankelijk zijn (= beroep doen op) de servicelaag en domeinobjecten.
- De servicelaag is afhankelijk van de Data Access Layer en de Domain Layer.
- De Data Access Layer is enkel afhankelijk van de Domain Layer.
Als we wijzigen doen aan de UI, zal geen enkele andere laag hiervan iets ondervinden. In de andere lagen probeer we concrete implementaties (bijv. welke database we hebben, of we SQL of een ORM-framework gebruiken, enzovoort) zoveel mogelijk te verbergen.
Wijzigingen in de domainmodellen, in de Domain Layer, zullen wel een invloed hebben op elk niveau. Een goede functionele analyse en een goede data-analyse is dus essentieel.
We kunnen de afhankelijkheden goed zien in onderstaande figuur:

Als je module main zich in de hoofdmap van je project bevindt, dan is de eenvoudigste manier om je project uit te voeren dit van die hoofdmap te doen.
python main.py
Bij grotere projecten is het mogelijk dat je bestand main.py zich bevindt in een package, bijv. cli_layer. In dat geval zal je je bestand moeten uitvoeren als een module:
python -m cli_package.main
Op die manier zorg je ervoor dat alle imports ook correct gebeuren.